ycliper

Популярное

Музыка Кино и Анимация Автомобили Животные Спорт Путешествия Игры Юмор

Интересные видео

2025 Сериалы Трейлеры Новости Как сделать Видеоуроки Diy своими руками

Топ запросов

смотреть а4 schoolboy runaway турецкий сериал смотреть мультфильмы эдисон

Видео с ютуба Kv Cache Quantization

How KV Cache Speeds Up LLMs for Faster AI Models on GPUs
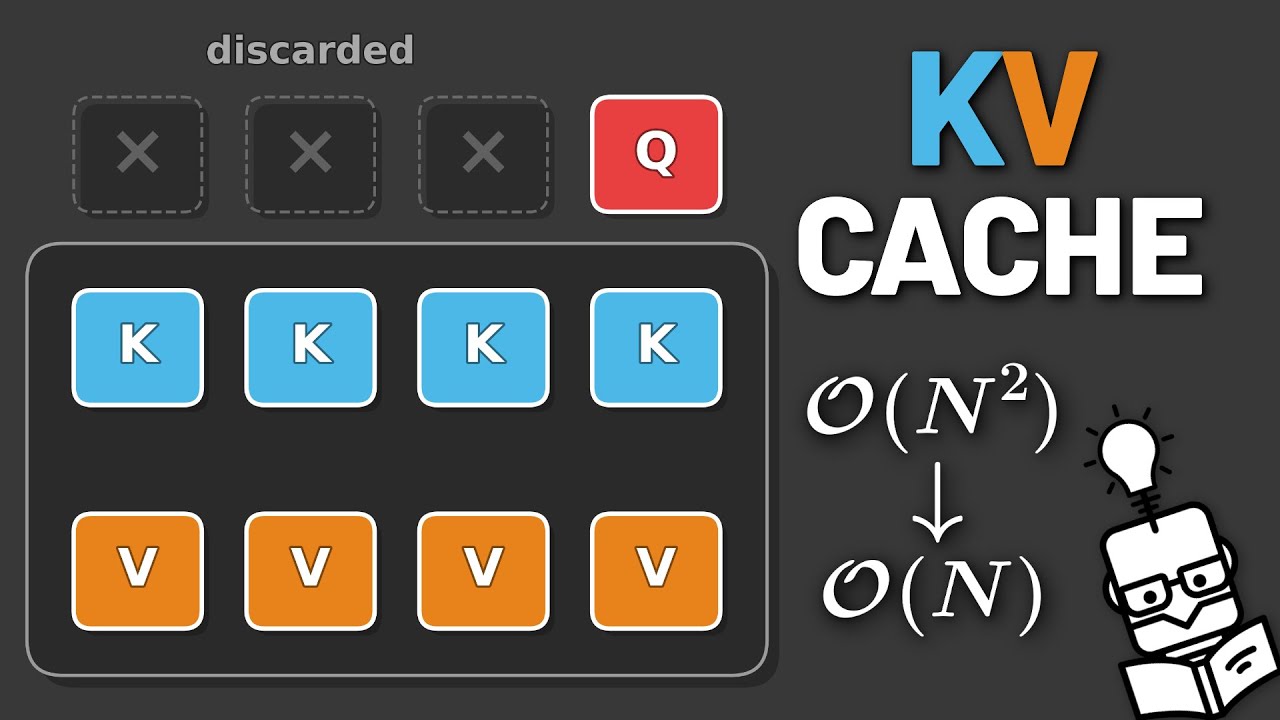
How KV Cache Speeds Up LLMs for Faster AI Models on GPUs

KV Cache - Explained

KV Cache - Explained

Объяснение TurboQuant: квантование 3-битного KV-кэша

Объяснение TurboQuant: квантование 3-битного KV-кэша

The KV Cache: Memory Usage in Transformers

The KV Cache: Memory Usage in Transformers

AI Inference Explained: KV Cache, Batching, Quantization and More | Viktor Farcic

AI Inference Explained: KV Cache, Batching, Quantization and More | Viktor Farcic

KV-кэш: трюк, который ускоряет LLM

KV-кэш: трюк, который ускоряет LLM

Stop Blindly Quantizing Your KV Cache (We Tested 4 Models)
Stop Blindly Quantizing Your KV Cache (We Tested 4 Models)

Оптимальный объем кэша ключ-значение: q4

Оптимальный объем кэша ключ-значение: q4

Inference Engineering Lecture 3: KV Cache, Prefill & Decode, GPU Architecture and TurboQuant

Inference Engineering Lecture 3: KV Cache, Prefill & Decode, GPU Architecture and TurboQuant

Как использовать квантование KV-кэша для создания более длинных текстов в LLM

Как использовать квантование KV-кэша для создания более длинных текстов в LLM

Run LLMs Locally: KV Cache, Quantization and GGUF Explained

Run LLMs Locally: KV Cache, Quantization and GGUF Explained

The KV Cache Explained: Why LLM Decoding Is Memory-Bound
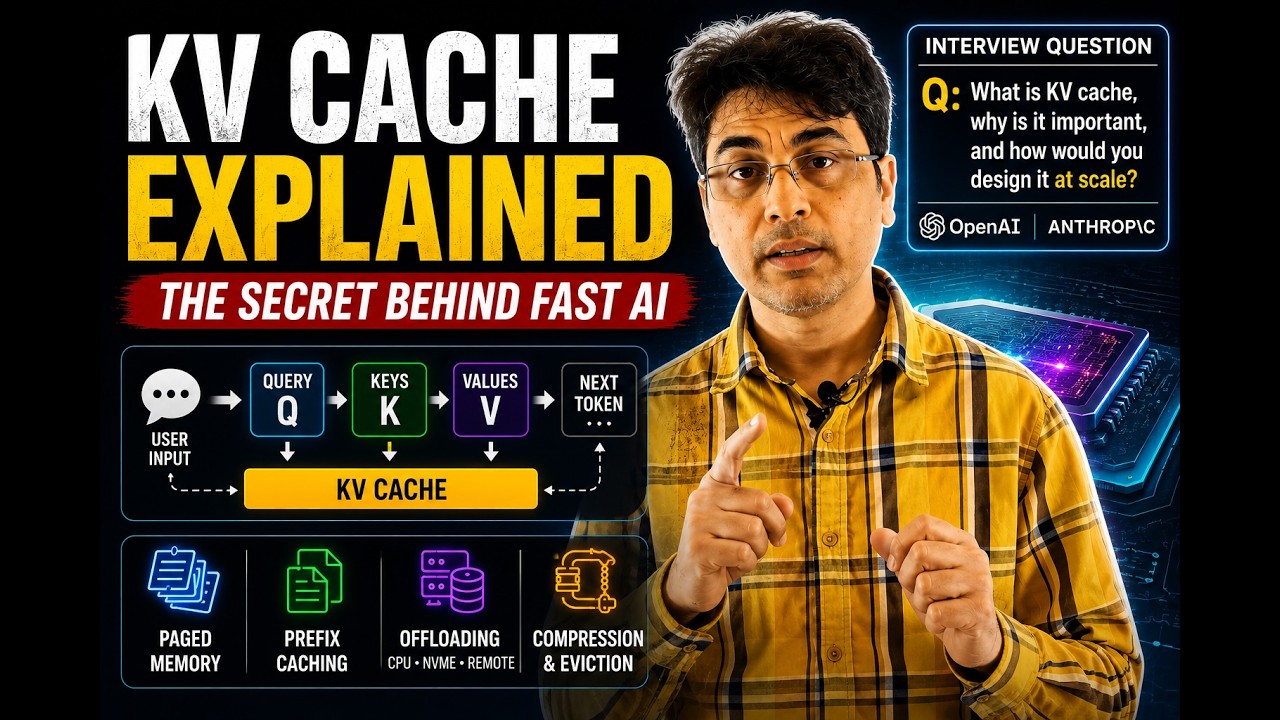
The KV Cache Explained: Why LLM Decoding Is Memory-Bound

KV Cache Explained | LLM Inference System Design and GPU Memory

KV Cache Explained | LLM Inference System Design and GPU Memory

Why LLM Inference Memory Grows With Context | KV Cache Explained Visually

Why LLM Inference Memory Grows With Context | KV Cache Explained Visually

KV Cache f16 vs q8 vs q4: Tested at Every Depth
KV Cache f16 vs q8 vs q4: Tested at Every Depth

Кэш KV за 15 мин

Кэш KV за 15 мин

After This, 16GB Feels Different

After This, 16GB Feels Different

Quantization & the KV Cache: Fitting a Giant Model into a Tiny GPU

Quantization & the KV Cache: Fitting a Giant Model into a Tiny GPU

Model vs Cache Quantization: quantizing the model does not shrink the KV cache

Model vs Cache Quantization: quantizing the model does not shrink the KV cache

Следующая страница»

© 2025 ycliper. Все права защищены.


  • Контакты
  • О нас
  • Политика конфиденциальности


Контакты для правообладателей: [email protected]